مقدمه: یک مدل وزنباز جدید
در ۱۳ مهر ۱۴۰۵ (۵ اکتبر ۲۰۲۶) شرکت Reflection AI از مدلی به نام Beam رونمایی کرد؛ مدلی که برای کدنویسی، کارهای عاملی و شکستن مسائل پیچیده طراحی شده و قرار است وزنهایش در ادامه اکتبر منتشر شود. این شرکت میگوید Beam از نظر توانایی همسطح برخی مدلهای متنباز چینی مثل GLM-5.2 از Z.ai و نزدیک به Qwen3.8-Max علیبابا است. این مقایسه ادعای خود شرکت است و هنوز بهصورت مستقل بررسی نشده.
این خبر فرصت خوبی است تا دو مفهوم پرتکرار را روشن کنیم: «مدل وزنباز» دقیقاً چیست و معماری Mixture of Experts (MoE) چطور کار میکند.
وزنباز، متنباز و بسته؛ تفاوت چیست؟
«وزنها» (weights) همان اعدادی هستند که پس از آموزش، دانش مدل را در خود ذخیره میکنند. بسته به اینکه چه چیزی در دسترس باشد:
- مدل بسته (closed): فقط از طریق API یا اپلیکیشن شرکت میتوانید از مدل استفاده کنید. وزنها منتشر نمیشوند.
- مدل وزنباز (open-weight): وزنها برای دانلود در دسترس است و میتوانید مدل را روی سختافزار خودتان اجرا کنید. اما کد آموزش و دادههای آموزش لزوماً منتشر نمیشوند و مجوز استفاده ممکن است محدودیت داشته باشد.
- متنباز کامل (open-source): علاوه بر وزنها، کد و گاهی داده آموزش هم با مجوز باز منتشر میشود. در عمل بسیاری از مدلهایی که «متنباز» نامیده میشوند، در واقع وزنباز هستند. قبل از استفاده تجاری حتماً متن مجوز را بخوانید.
Mixture of Experts چیست؟
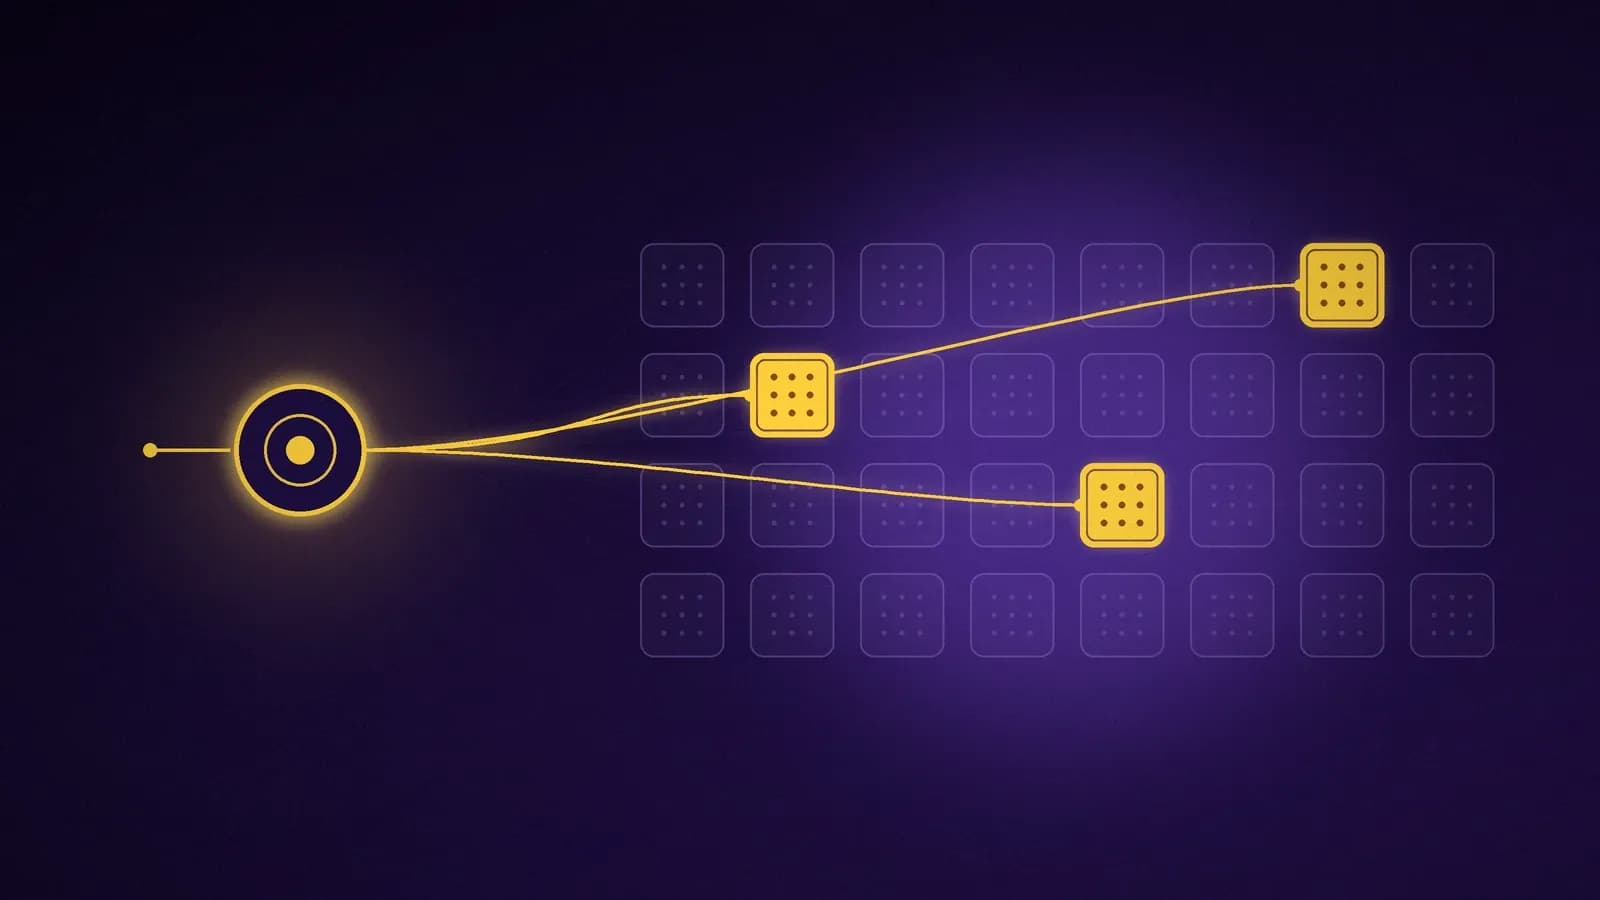
در یک مدل «متراکم» (dense) هر بار که متنی پردازش میشود، تمام پارامترهای مدل فعال میشوند. در Mixture of Experts مدل از چند زیرشبکه به نام «متخصص» (expert) تشکیل شده و یک بخش کوچک به نام مسیریاب (router) برای هر توکن تصمیم میگیرد کدام چند متخصص فعال شوند.
نتیجه این است که:
- پارامترهای کل مدل (total) خیلی زیاد است، چون همه متخصصها را شامل میشود.
- پارامترهای فعال (active) برای هر توکن بسیار کمتر است. مثل یک بیمارستان بزرگ است: صدها پزشک متخصص دارد، اما برای هر بیمار فقط چند نفرشان وارد میشوند. ظرفیت دانش زیاد است ولی هزینه محاسبه هر پاسخ کمتر.
درباره Beam، گزارشهایی که بررسی کردیم تعداد دقیق پارامترها را تأیید نکردند؛ جزئیات قرار است در گزارش فنی شرکت بیاید، پس عدد ننوشتهایم.
اجرای محلی چه نیازهایی دارد؟
یک نکته مهم که اغلب نادیده گرفته میشود:
- حافظه GPU برای نگه داشتن مدل، به تعداد کل پارامترها وابسته است، چون همه متخصصها باید در دسترس باشند.
- سرعت و هزینه محاسبه هر توکن، بیشتر به پارامترهای فعال وابسته است. یعنی MoE سرعت و هزینه محاسبه را کم میکند، اما نیاز به حافظه را لزوماً کم نمیکند. برای استقرار در سازمان باید هر دو را بسنجید: چند GPU، با چه حافظهای و چه ترافیکی.
چطور یک مدل وزنباز را ارزیابی کنیم؟
قبل از اینکه مدلی را انتخاب کنید، این فهرست را بروید:
- مجوز: آیا استفاده تجاری، تنظیم دقیق (fine-tuning) و بازتوزیع مجاز است؟
- بنچمارک شخصی: ۵۰ تا ۱۰۰ نمونه واقعی از کار خودتان را روی مدل امتحان کنید. نتایج بنچمارک عمومی کافی نیست.
- زبان فارسی: کیفیت مدل در متن فارسی را جداگانه بسنجید.
- سختافزار: هزینه سرو (serving) را با واقعیت زیرساخت خودتان بسنجید.
- ایمنی و بهروزرسانی: چه کسی وصلهها و نسخههای جدید را منتشر میکند؟
- گزارش فنی مستقل: منتظر ارزیابیهای بیرونی بمانید، بهخصوص برای ادعاهایی مثل «همسطح فلان مدل».
جمعبندی
مدلهای وزنباز به سازمانها امکان کنترل داده، سفارشیسازی و استقرار محلی میدهند و معماری MoE آنها را از نظر هزینه محاسبه رقابتیتر میکند. اما «وزنباز» به معنای «رایگان و بدون محدودیت» نیست و هر مدل را باید با داده و سختافزار خودتان آزمود. Beam فعلاً یک گزینه جدید برای ارزیابی است؛ نه جایگزین قطعی.